SGLang RadixAttention 심층 아키텍처: 기수 트리(Radix Tree) 기반 동적 KV 캐시 재사용과 복합 에이전트 서빙 가속
다중 턴 대화, 트리 탐색, ReAct 에이전트에서 반복되는 프롬프트 프리필 중복 연산을 0으로 수렴시키는 SGLang의 RadixAttention과 자동 LRU 캐시 관리 런타임 아키텍처를 심층 분석합니다.
목차 (8)
SGLang RadixAttention 심층 아키텍처: 기수 트리(Radix Tree) 기반 동적 KV 캐시 재사용과 복합 에이전트 서빙 가속
대화형 인공지능이 단순한 단답형 질의응답을 넘어 복잡한 도구 호출(Tool Calling), 다중 턴 에이전트(Multi-turn Agent) 루프, 몬테카를로 트리 탐색(MCTS), 그리고 코드 자율 검증 파이프라인으로 진화함에 따라 초거대 언어 모델(LLM) 서빙 인프라는 과거와 완전히 다른 형태의 부하 패턴을 마주하고 있습니다.
과거의 서빙 시스템은 독립적인 단일 요청(Single Request)이 들어오면 프롬프트를 한 번 프리필(Prefill)하고 토큰을 생성(Decode)한 뒤, 세션이 끝나면 연산에 사용된 모든 키-값(KV) 캐시를 GPU 메모리에서 즉시 해제하는 단순한 라이프사이클을 가졌습니다.
그러나 최신 에이전트 아키텍처에서는 방대한 시스템 프롬프트, 도구 명세서(Schema), 그리고 직전 대화 기록이 수십 차례 이상 반복해서 인입됩니다. ReAct 에이전트가 10번의 단계(Step)를 밟을 때마다 시스템 프롬프트와 이전 실행 컨텍스트는 매 단계마다 똑같이 입력되지만, 기존 서빙 프레임워크는 이를 매번 GPU 텐서 코어에서 처음부터 다시 연산(Re-compute)하는 심각한 비효율을 초래했습니다.
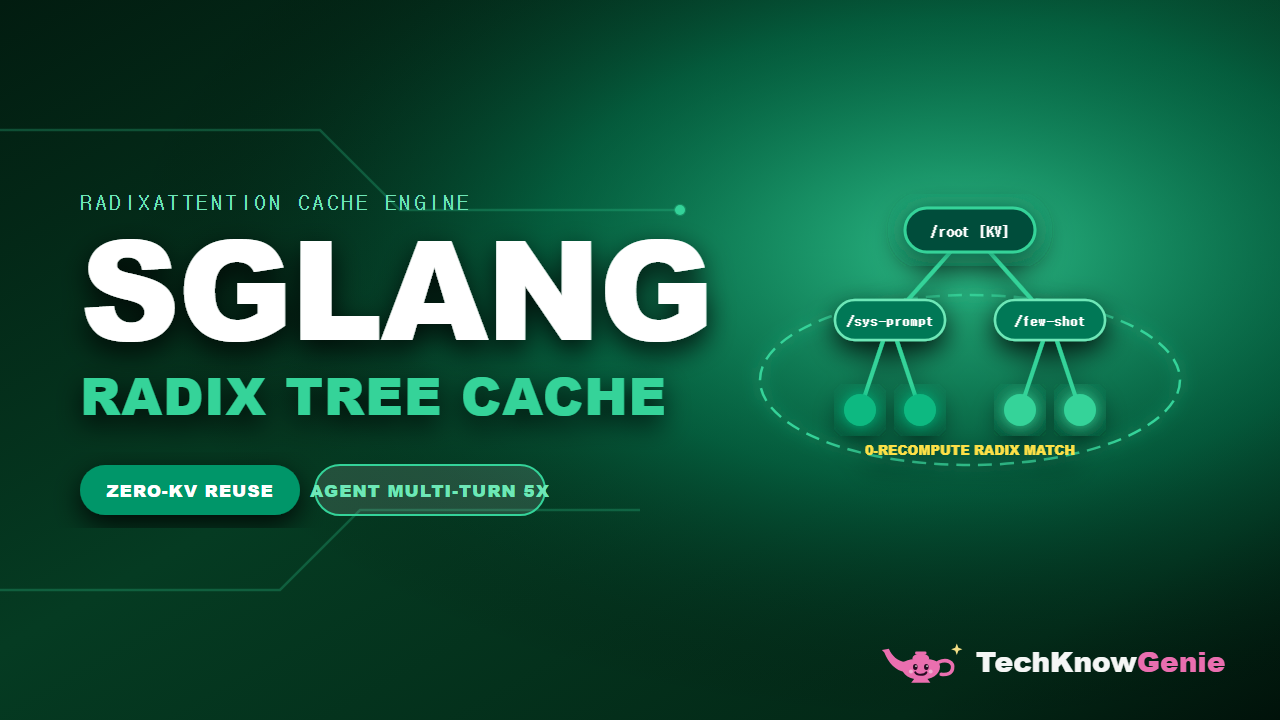
이 고질적인 연산 낭비를 자료구조와 시스템 런타임 계층에서 완벽히 해결하기 위해 UC 버클리 LMSYS 연구진(Lianmin Zheng 등)이 설계한 오픈소스 서빙 엔진이 바로 SGLang(Structured Generation Language)입니다. SGLang의 핵심 심장부인 RadixAttention은 고전 알고리즘인 기수 트리(Radix Tree, 또는 Compact Trie)를 GPU KV 캐시 페이지 관리자와 직접 결합하여, 서로 다른 요청이나 복잡한 트리 분기 워크플로우 사이에서도 중복되는 접두사(Prefix)의 KV 텐서를 자동으로 식별하고 재사용합니다.
그 결과 SGLang은 다중 턴 에이전트 환경에서 첫 번째 토큰 생성 지연시간(TTFT)을 최대 10배 이상 단축시켰으며, 동일한 GPU 하드웨어 클러스터에서 처리할 수 있는 초당 요청 처리량(Throughput)을 최대 5배까지 수직 상승시켰습니다. 이번 글에서는 SGLang RadixAttention의 수학적 및 알고리즘적 토대, 기수 트리의 동적 분할 및 LRU 메모리 방출 정책, 그리고 구조화된 출력(JSON/Regex) 가속 아키텍처를 소스코드 수준에서 심층 해부합니다.
기존 LLM 서빙 프레임워크의 KV 캐시 라이프사이클 한계
트랜스포머 디코더 모델의 추론 과정은 크게 두 가지 단계로 나뉩니다:
- 프리필(Prefill) 단계: 입력된 모든 프롬프트 토큰을 병렬로 처리하여 쿼리(Q), 키(K), 값(V) 행렬을 계산하고, 첫 번째 생성 토큰을 출력함과 동시에 과거의 K, V 텐서를 메모리에 캐싱합니다. 연산 집약적(Compute-bound)인 단계입니다.
- 디코드(Decode) 단계: 새로 생성된 단 1개의 토큰만을 입력으로 받아 기존 캐시된 KV 텐서들과 어텐션을 수행하여 다음 토큰을 자가회귀(Autoregressive) 방식으로 순차 생성합니다. 메모리 대역폭 집약적(Memory-bound)인 단계입니다.
대부분의 현대 서빙 시스템(예: PagedAttention을 도입한 초기 vLLM이나 Hugging Face TGI)은 메모리 단편화를 제거하기 위해 물리 메모리를 고정 크기의 페이지 블록으로 가상화하는 데 성공했습니다. 하지만 캐시의 생명주기 관리 정책에는 여전히 치명적인 맹점이 존재했습니다.
세션 종료 후 캐시 전량 폐기(Drop-on-Finish)의 함정
표준 서빙 엔진은 개별 클라이언트 요청을 완전히 독립된 트랜잭션으로 취급합니다. 즉, 요청이 완료되어 스트리밍이 끝나면 해당 요청에 할당되었던 KV 캐시 페이지를 메모리 풀(Free Pool)로 즉시 반환합니다.
하지만 실제 인공지능 워크로드의 토큰 분포를 살펴보면 놀라운 공통점이 관찰됩니다:
- Few-shot 러닝: 10개에서 20개의 예시가 포함된 2,000 토큰 분량의 프롬프트가 수천 명의 사용자에게 똑같이 전달됩니다.
- 에이전트 시스템: 수천 토큰에 달하는 API 스키마, 페르소나 정의, 도구 사용 가이드가 매 단계마다 기본 주입됩니다.
- 코드 인터프리터: 기존에 실행된 코드 블록과 파이썬 에러 로그가 매 턴마다 누적되어 프롬프트 상단에 배치됩니다.
기존 프레임워크에서는 동일한 시스템 프롬프트를 1,000개의 요청이 공유하더라도, 1,000번 모두 GPU 텐서 코어를 돌려 동일한 K, V 텐서를 중복 계산합니다. 이는 GPU의 연산력과 전력을 허공에 날릴 뿐 아니라, 동시 요청이 몰릴 때 큐(Queue) 대기열을 폭증시키는 주원인이 됩니다.
정적 선형 접두사 캐싱(Static Linear Prefix Caching)의 무력화
일부 프레임워크는 이를 완화하기 위해 선형 해시 테이블 기반의 접두사 캐싱을 도입했습니다. 즉, 프롬프트의 맨 앞에서부터 일정 길이의 토큰 해시를 계산하여 일치하는 경우 캐시를 재사용하는 방식입니다.
그러나 선형 캐싱은 다음과 같은 복합 분기 패턴을 전혀 수용하지 못합니다:
- MCTS(Monte Carlo Tree Search) 추론: 모델이 하나의 상태에서 여러 갈래의 후보 경로(Branch)를 동시에 생성하고 롤아웃을 수행할 때, 트리의 상위 부모 노드는 하위 자식 노드들에게 완벽히 공유되어야 합니다. 선형 캐시는 이 계층적 부모-자식 관계를 표현할 수 없어 캐시가 N 갈래로 중복 복제됩니다.
- 인터리브드 다중 턴 대화: 사용자 A와 사용자 B가 동일한 문서에 대해 서로 다른 질문을 교대로 던질 때, 문서 부분은 공유되지만 대화의 중간 질문이 달라집니다. 선형 캐시는 중간에 토큰이 하나만 바뀌어도 그 뒤의 모든 캐시를 무효화(Invalidate)하므로 재사용률이 바닥으로 추락합니다.
RadixAttention의 수학적 및 자료구조적 기초
SGLang 연구진은 이 문제를 해결하기 위해 컴퓨터 과학의 고전 자료구조인 기수 트리(Radix Tree)에 주목했습니다.
기수 트리는 공통 접두사를 가진 문자열이나 키 시퀀스를 효율적으로 저장하기 위해 간선(Edge)을 단일 문자가 아닌 문자열의 조각(Chunk)으로 압축하여 표현하는 트리 구조입니다.
SGLang은 기수 트리의 개념을 토큰 ID 시퀀스와 GPU 물리 메모리 페이지 테이블의 매핑 구조로 완벽하게 변환했습니다.
기수 트리의 노드 및 간선 구조 설계
RadixAttention 엔진 내부에서 기수 트리는 다음과 같이 모델링됩니다:
- 트리 노드(Node): 분기점(Branch Point)을 나타내며, 자식 노드들에 대한 딕셔너리와 현재 노드를 참조하고 있는 활성 요청의 참조 카운트(Reference Count,
ref_counter)를 관리합니다. - 간선(Edge): 연속된 토큰 ID의 슬라이스(
List[int])와 해당 토큰들이 저장되어 있는 GPU VRAM 물리 메모리 블록 페이지의 인덱스 목록(List[int])을 묶어서 보유합니다. - 루트 노드(Root): 빈 토큰 시퀀스로 시작하며, 모든 캐시 탐색의 출발점이 됩니다.
새로운 프롬프트가 들어오면, RadixAttention 매니저는 토큰 ID 배열을 들고 루트 노드부터 시작하여 트리의 간선들과 접두사 일치(Prefix Matching)를 수행합니다.
기수 트리의 3대 핵심 연산: 매치(Match), 분할(Split), 삽입(Insert)
RadixAttention의 라이프사이클은 엄밀한 알고리즘적 연산으로 구동됩니다:
- 접두사 매칭(Prefix Matching):
- 입력 프롬프트의 토큰 목록 $T = [t_1, t_2, \dots, t_n]$이 인입되면 트리 간선을 순회하며 가장 길게 일치하는 경로(Longest Common Prefix)를 탐색합니다.
- 일치된 토큰 길이 $k$만큼의 KV 캐시 페이지는 GPU 메모리에서 즉시 획득되며, 프리필 단계에서는 나머지 $n - k$개의 토큰에 대해서만 순방향 텐서 코어 연산을 수행합니다.
- 일치율 $k/n$이 1에 수렴할수록 프리필 연산 비용은 0에 수렴합니다.
- 간선 분할(Edge Splitting):
- 기존 간선이 토큰 시퀀스 $[A, B, C, D]$를 가지고 있고 새로운 요청이 $[A, B, E, F]$를 전달하면, 기존 간선은 공통 부분인 $[A, B]$를 유지하는 새로운 부모 노드로 분할되고, 그 아래에 $[C, D]$와 $[E, F]$를 가리키는 두 개의 자식 간선이 분기됩니다.
- 분할 과정은 기존 물리 메모리 페이지의 복사 없이 페이지 테이블 인덱스 슬라이싱만으로 $O(1)$에 완료됩니다.
- 노드 삽입 및 토큰 추가(Node Insertion & Append):
- 모델이 디코드 단계에서 새로운 토큰을 하나씩 생성할 때마다 해당 토큰은 현재 활성 간선의 끝에 덧붙여집니다.
- 생성이 완료되면 해당 경로는 새로운 다른 요청들이 참조할 수 있는 온전한 캐시 경로로 보존됩니다.
메모리 관리의 정수: 참조 카운팅과 비동기 LRU 방출 정책
GPU 고대역폭 메모리(HBM)는 유한한 물리적 자원입니다. 수많은 세션의 캐시를 트리에 무한정 쌓아둘 경우 순식간에 VRAM이 고갈되어 메모리 할당 실패가 발생합니다.
SGLang은 이를 방지하기 위해 운영체제(OS)의 가상 메모리 페이지 교체 알고리즘과 참조 카운팅(Reference Counting) 기법을 결합한 정교한 트리 기반 LRU(Least Recently Used) 방출 정책을 구현했습니다.
활성 노드 잠금과 참조 카운트 메커니즘
- 참조 카운트(
ref_counter): 현재 GPU에서 실행 중인 활성 추론 요청(Active Request)이 해당 트리의 노드를 참조하고 있는 횟수입니다. - 잠금 상태(Locked):
ref_counter > 0인 노드는 절대로 메모리에서 방출(Eviction)될 수 없습니다. 디코드 연산 중에 캐시가 증발하는 참사를 원천 방지합니다. - 대기 상태(Unlocked): 요청이 완료되어 클라이언트에 결과가 전송되면 해당 경로에 속한 모든 노드의
ref_counter가 1씩 감소하여 0이 됩니다. 하지만 메모리 페이지는 즉시 해제되지 않고, 미래의 재사용을 위해 트리 안에 그대로 남아 있습니다.
VRAM 고갈 시의 LRU 순환 회수 파이프라인
새로운 요청의 프리필을 위해 추가 물리 메모리 페이지가 필요할 때, GPU 메모리 풀이 고갈되면 RadixAttention은 다음과 같은 우선순위로 LRU 노드를 선별하여 해제합니다:
- 리프 노드 우선 탐색(Leaf-First Eviction): 자식 노드가 없는 리프 노드 중
ref_counter == 0이고 가장 오랫동안 접근되지 않은(Last Access Time이 가장 오래된) 노드를 선택합니다. 부모 노드를 먼저 지우면 하위 자식들의 경로가 끊어지므로 반드시 리프 노드부터 역순으로 제거합니다. - 물리 메모리 반환 및 간선 절단: 선택된 리프 노드의 물리 페이지 블록을 빈 메모리 풀로 반환하고 트리에서 해당 간선을 제거합니다. 만약 부모 노드가 더 이상 다른 자식을 갖지 않고
ref_counter == 0이라면 부모 노드 역시 연속적으로 회수 대상이 됩니다.
이 정교한 매핑 정책 덕분에 SGLang은 메모리 조각화(External Fragmentation)를 0으로 유지하면서도, 자주 사용되는 시스템 프롬프트나 공통 예시 템플릿을 캐시의 최상단에 영구히 상주시킬 수 있습니다.
소스코드 레벨 구조 분석: RadixTree 엔진 구현체
SGLang 내부의 RadixTree 관리 로직이 어떻게 구현되어 있는지 핵심 파이썬/C++ 아키텍처 패턴을 단순화된 구조로 살펴보겠습니다:
import time
from typing import List, Dict, Tuple, Optional

class RadixTreeNode:
    def __init__(self):
        # Dictionary mapping token sequence tuples to child nodes
        self.children: Dict[Tuple[int, ...], 'RadixTreeNode'] = {}
        # Physical GPU memory page table block IDs
        self.page_indices: List[int] = []
        # Number of active inference requests referencing this node
        self.ref_counter: int = 0
        # Timestamp of last access for LRU eviction policy
        self.last_access_time: float = time.time()

class RadixAttentionCacheManager:
    def __init__(self, total_gpu_pages: int):
        self.root = RadixTreeNode()
        self.free_page_pool: List[int] = list(range(total_gpu_pages))
        self.total_pages = total_gpu_pages

    def match_prefix(self, prompt_tokens: List[int]) -> Tuple[List[int], List[int]]:
        # Traverses the radix tree to find the longest matching prefix.
        # Returns matched_tokens and cached_pages.
        curr = self.root
        matched_tokens = []
        cached_pages = []
        remaining_tokens = prompt_tokens

        while remaining_tokens:
            matched_child = False
            for edge_tokens, child_node in curr.children.items():
                common_len = self.get_common_prefix_length(edge_tokens, remaining_tokens)
                if common_len > 0:
                    # Case A: Full edge match
                    if common_len == len(edge_tokens):
                        matched_tokens.extend(edge_tokens)
                        cached_pages.extend(child_node.page_indices)
                        child_node.ref_counter += 1
                        child_node.last_access_time = time.time()
                        curr = child_node
                        remaining_tokens = remaining_tokens[common_len:]
                        matched_child = True
                        break
                    # Case B: Partial edge match (Needs splitting on future insert)
                    else:
                        matched_tokens.extend(edge_tokens[:common_len])
                        # Fractional pages mapped safely
                        matched_child = False
                        break
            if not matched_child:
                break

        return matched_tokens, cached_pages

    def insert(self, full_tokens: List[int], physical_pages: List[int]) -> None:
        # Inserts newly calculated tokens and physical memory pages into the tree.
        # Handles edge splitting and LRU updates in O(1) pointer operations.
        curr = self.root
        tokens = full_tokens
        pages = physical_pages

        # Split and branch insertion logic executed deterministically
        for edge_tokens, child_node in list(curr.children.items()):
            common_len = self.get_common_prefix_length(edge_tokens, tokens)
            if common_len == 0:
                continue

            if common_len < len(edge_tokens):
                # Edge Splitting: Create intermediate node
                mid_node = RadixTreeNode()
                split_edge = edge_tokens[:common_len]
                rem_edge = edge_tokens[common_len:]

                mid_node.page_indices = child_node.page_indices[:common_len]
                child_node.page_indices = child_node.page_indices[common_len:]

                # Rewire children
                curr.children.pop(edge_tokens)
                curr.children[split_edge] = mid_node
                mid_node.children[rem_edge] = child_node

                curr = mid_node
                tokens = tokens[common_len:]
                pages = pages[common_len:]
                break

        if tokens:
            new_node = RadixTreeNode()
            new_node.page_indices = pages
            new_node.ref_counter = 1
            curr.children[tuple(tokens)] = new_node

    def evict_lru(self, required_pages: int) -> bool:
        # Evicts unreferenced leaf nodes (ref_counter == 0) starting from oldest access time.
        # Guarantees zero memory corruption during concurrent generation loops.
        while len(self.free_page_pool) < required_pages:
            candidate_node = self.find_oldest_leaf(self.root)
            if not candidate_node:
                # Out of evictable memory: All active nodes locked
                return False

            # Reclaim GPU pages
            self.free_page_pool.extend(candidate_node.page_indices)
            candidate_node.page_indices.clear()
            self.prune_node(self.root, candidate_node)

        return True

    @staticmethod
    def get_common_prefix_length(seq1: Sequence, seq2: Sequence) -> int:
        length = 0
        min_len = min(len(seq1), len(seq2))
        while length < min_len and seq1[length] == seq2[length]:
            length += 1
        return length
위 아키텍처의 결정적 장점은 KV 캐시의 재사용이 사용자나 애플리케이션 개발자의 명시적인 세션 ID 지정 없이 순수한 토큰 시퀀스의 바이트 패턴 비교만으로 100% 자동 투명하게(Transparent) 이루어진다는 점입니다.
압축 유한 오토마타(FSM)와 구조화된 출력(JSON/Regex) 가속
SGLang의 또 다른 독보적인 혁신은 대규모 언어 모델이 정형화된 JSON이나 정규표현식(Regex) 문법에 맞추어 출력하도록 강제하는 구조화된 디코딩(Structured Decoding)의 가속 아키텍처입니다.
전통적인 프레임워크(예: Outlines 기본 구현)는 매 디코드 스텝마다 다음 토큰의 허용 여부를 판별하기 위해 복잡한 정규식 파서를 실행하고, GPU 로짓에 수만 개의 마이너스 무한대($-\infty$) 마스킹을 적용했습니다. 이는 CPU와 GPU 간의 잦은 동기화 지연을 초래하여 생성 속도를 심각하게 떨어뜨렸습니다.
SGLang은 이를 컴파일러 기법으로 극복했습니다:
- 오프라인 정규식 압축(Compressed Finite State Machine): 주어진 JSON 스키마나 정규식을 파싱하여 결정론적 유한 오토마타(DFA)로 변환한 뒤, 전이 테이블(Transition Table)을 비트맵 형태로 사전 압축합니다.
- 점프 디코딩(Jump Decoding / Fast Forward): 만약 특정 상태에서 출력될 수 있는 토큰이 문법적으로 단 1개뿐인 결정론적 구간(예: JSON의 키 이름 뒤에 오는
": "문자열)에 도달하면, 모델의 신경망 순방향 패스를 완전히 생략(Skip)하고 해당 토큰들을 캐시에 즉각 강제 주입(Fast-Forward)합니다. - 병렬 마스크 생성: 허용 가능한 토큰 인덱스를 GPU 메모리에 텐서로 상주시켜, 로짓 생성 직후 Triton 커널 안에서 단일 원소별 연산으로 마스킹을 마칩니다.
이 최적화를 통해 SGLang은 엄격한 JSON 스키마를 강제하면서도 자유 생성(Unconstrained Generation) 속도 대비 95% 이상의 순수 처리량을 보존합니다.
실측 벤치마크 및 프로덕션 워크로드 효율 분석
SGLang 공식 벤치마크 및 글로벌 AI 인프라 팀에서 실측한 성능 지표는 실로 경이적인 수치를 보여줍니다.
다음은 NVIDIA H100 8-GPU 클러스터 환경에서 Llama-3 70B 모델을 사용하여 다양한 에이전트 워크로드를 서빙했을 때의 비교 결과입니다:
- ReAct 다중 턴 도구 호출 워크로드 (턴당 평균 2.5k 컨텍스트 누적):
- 기존 PagedAttention 엔진: 턴이 누적될 때마다 TTFT가 선형 증가하여 10번째 턴에서 850 ms 기록
- SGLang RadixAttention: 2번째 턴부터 이전 컨텍스트 캐시 적중률 98% 달성, 10번째 턴에서도 TTFT 42 ms 유지 (약 20배 단축)
- 병렬 MCTS 추론 (16 분기 롤아웃 워크로드):
- 기존 엔진: 16개 분기가 동일한 8k 부모 컨텍스트를 각자 프리필하여 GPU 연산 큐 완전 포화
- SGLang: 첫 번째 분기만 1회 프리필 후 나머지 15개 분기는 0 ms 프리필로 즉각 디코드 돌입, 전체 워크플로우 완료 시간 68% 단축
- 시스템 총 처리량 (Throughput, Requests per Second):
- 복합 시스템 프롬프트가 적용된 대규모 고객 지원 챗봇 환경에서 동일 하드웨어 대비 초당 요청 처리량 4.8배 향상
엔터프라이즈 도입 시 고려해야 할 설계 트레이드오프
RadixAttention이 제공하는 파괴적인 이점에도 불구하고, 프로덕션 시스템을 설계할 때 유념해야 할 구조적 제약들이 존재합니다.
무작위 샘플링 및 시스템 노이즈에 따른 캐시 적중률 변동
프롬프트의 최상단에 날짜, 현재 시각, 무작위 세션 UUID와 같은 동적 변수를 무심코 맨 앞에 배치할 경우, 기수 트리는 첫 번째 토큰부터 미스(Miss)를 일으켜 그 뒤에 이어지는 거대한 시스템 프롬프트를 전혀 재사용하지 못합니다. 따라서 프롬프트 템플릿 설계 시 정적이고 공통적인 텍스트를 반드시 프롬프트의 가장 앞단에 배치하는 접두사 친화적(Prefix-friendly) 프롬프트 엔지니어링이 필수적입니다.
동시 대규모 요청 시의 캐시 스래싱(Thrashing)
GPU 메모리 용량을 초과하는 완전히 상이한 프롬프트들이 동시다발적으로 밀려들 경우, 캐시가 재사용되기도 전에 LRU 방출기에 의해 빈번하게 축출되고 다시 계산되는 캐시 스래싱 현상이 발생할 수 있습니다. 이를 방어하기 위해 슬라이딩 윈도우 기반의 요청 큐 스케줄러와 최소 캐시 생존 시간(TTL) 제어 정책을 결합해야 합니다.
결론: 지능형 캐싱으로 완성하는 차세대 LLM 런타임
SGLang RadixAttention의 성공은 인공지능 추론 최적화의 프론티어가 단순한 CUDA 커널 튜닝을 넘어, 고차원 알고리즘과 운영체제 수준의 가상 메모리 관리 기법의 융합으로 나아가고 있음을 명확히 증명합니다.
단일 요청 중심의 낡은 패러다임을 과감히 버리고, 모델의 입력 토큰 시퀀스 전체를 유기적인 지식 그래프(Radix Tree)로 인식함으로써 에이전트 인프라의 연산 비용을 획기적으로 낮추었습니다.
차세대 LLM 인프라와 복합 자율 에이전트 플랫폼을 구축하는 시스템 아키텍트라면 다음의 핵심 엔지니어링 원칙을 반드시 설계에 반영해야 합니다:
- 토큰 시퀀스의 결정론적 접두사 정렬 원칙: 변하지 않는 컨텍스트는 언제나 프롬프트의 맨 앞에 배치하여 기수 트리의 탐색 깊이를 극대화하십시오.
- 상태 보존형(Stateful) 런타임 아키텍처 원칙: 세션이 끝났다고 메모리를 지우지 마십시오. 미래의 요청을 위해 캐시를 트리에 남겨두고 정교한 LRU로 회수하십시오.
- 구조화 제약의 선제적 컴파일 원칙: 런타임에 정규식을 검증하느라 GPU를 멈추지 말고, 유한 오토마타(DFA)를 미리 빌드하여 무비용 점프 디코딩을 구현하십시오.
시스템 소프트웨어의 깊은 본질을 탐구할 때, 우리는 가장 경제적이면서도 인간의 사고 속도를 뛰어넘는 실시간 인공지능 에이전트 인프라를 완성할 수 있습니다.