PyTorch 2.0+ 컴파일러 아키텍처: TorchDynamo 프레임 가로채기, FX Graph 최적화 및 TorchInductor Triton 자동 코드 생성 파이프라인 심층 해부
Eager 모드의 직관성을 유지하면서 CPython 바이트코드 가로채기(PEP 523), AOTAutograd 그래프 정규화, 그리고 TorchInductor의 자동 Triton GPU 커널 융합을 통해 최대 2.5배 훈련 및 추론 가속을 실현하는 PyTorch 2.0 컴파일러 스택 전 과정 분석
목차 (7)
인공지능 연구원들과 머신러닝 엔지니어들이 텐서플로우의 정적 그래프를 떠나 파이토치를 사실상의 글로벌 표준 프레임워크로 선택했던 결정적인 이유는 바로 즉시 실행 모드가 선사하는 유연성과 직관적인 파이썬 디버깅 경험이었습니다. 코드를 작성하는 족족 한 줄씩 즉시 연산 결과가 반환되고, 표준 파이썬의 조건문과 반복문, 중단점을 자유자재로 활용할 수 있는 이점은 딥러닝 연구의 패러다임을 송두리째 바꾸어 놓았습니다.
하지만 모델의 규모가 수백억, 수천억 파라미터로 폭발하고 최신 GPU 하드웨어의 클록 속도가 가속화되면서, 즉시 실행 모드의 구조적 한계는 엔터프라이즈 인프라의 가장 심각한 비용 유발 요인으로 대두되었습니다. 연산자 하나를 호출할 때마다 발생하는 CPython 인터프리터의 디스패치 오버헤드, 파이토치 C++ 내부 디스패처 계층의 탐색 비용, 그리고 무엇보다 수많은 개별 텐서 연산마다 GPU 고대역폭 메모리와 연산 코어 사이를 무의미하게 오가는 메모리 왕복 대역폭 기근이 텐서 코어의 막강한 연산 자원을 낭비하게 만들었습니다.
파이토치 팀이 과거 시도했던 TorchScript는 이러한 문제를 해결하고자 정적 컴파일을 도입했으나, 파이썬의 동적 문법을 엄격히 제한하고 런타임 오류 추적을 극도로 어렵게 만들어 대다수 엔지니어들에게 외면받았습니다.
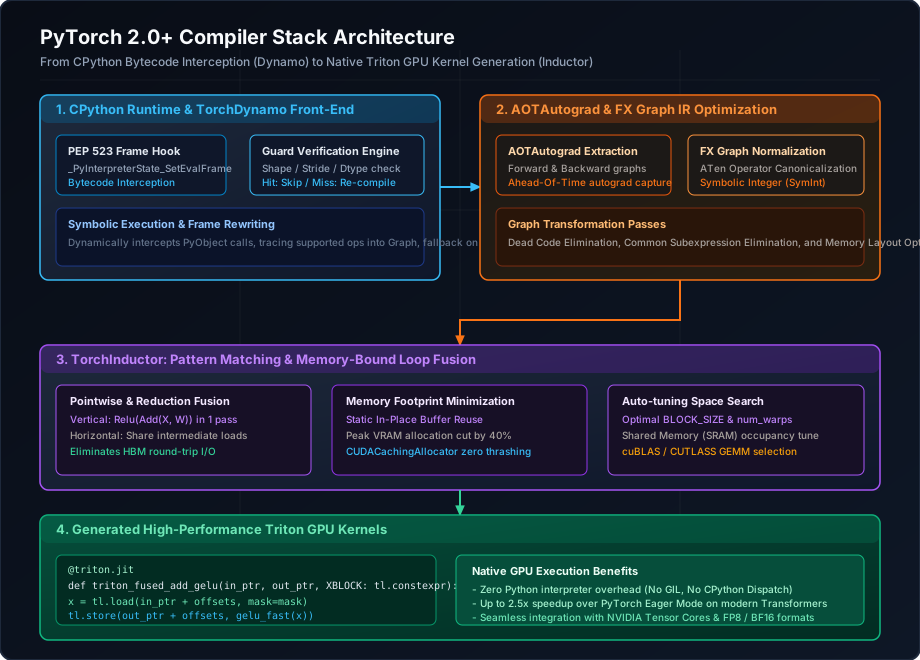
파이토치 2.0 이상에서 도입된 컴파일러 스택은 이러한 오랜 딜레마에 마침표를 찍었습니다. 파이썬 바이트코드 가로채기 엔진인 TorchDynamo, 순전파와 역전파 그래프를 사전에 온전히 추출하는 AOTAutograd, 정규화된 중간 표현을 다루는 FX Graph, 그리고 메모리 바운드 연산자들을 단일 GPU 커널로 융합하여 네이티브 코드를 합성하는 TorchInductor와 Triton 백엔드로 이어지는 모듈러 컴파일러 파이프라인을 완성했습니다.
한 줄의 코드 추가만으로 파이썬의 완전한 동적성을 보존하면서도 하드웨어 한계에 근접하는 극대화된 연산 효율을 이끌어내는 파이토치 컴파일러 스택의 내부 동작 원리를 심층적으로 추적해 보겠습니다.
즉시 실행 모드의 구조적 병목과 정적 컴파일러의 실패 원인
파이토치의 즉시 실행 모드는 코드가 파이썬 인터프리터에 의해 실행되는 순간 GPU에 개별 CUDA 커널을 런칭하는 방식으로 동작합니다.
예를 들어 잔차 연결과 활성화 함수, 레이어 정규화가 결합된 전형적인 트랜스포머 블록의 연산을 생각해 보겠습니다. 입력 텐서 X와 가중치 투영 결과 Y를 더하고, 그 결과에 바이어스를 더한 뒤 GELU 활성화 함수를 통과시키는 일련의 과정이 코드로 실행된다고 가정합니다.
즉시 실행 모드에서는 덧셈 연산자 하나를 위해 첫 번째 CUDA 커널이 호출됩니다. 이 커널은 GPU 고대역폭 메모리에서 텐서 X와 Y의 원소들을 읽어 들여 텐서 코어에서 덧셈을 수행한 뒤, 그 중간 결과물을 다시 고대역폭 메모리에 기록합니다. 바로 다음 줄에서 바이어스 덧셈 커널이 호출되면, 방금 전 메모리에 기록했던 중간 텐서를 다시 읽어와 바이어스를 더하고 또다시 메모리에 씁니다. 마지막으로 GELU 커널이 호출되어 메모리에 저장된 값을 다시 읽어와 비선형 활성화 수식을 계산하고 최종 결과를 메모리에 저장합니다.
이 간단한 세 단계의 연산 과정에서 데이터는 고대역폭 메모리와 온칩 연산 레지스터 사이를 세 번이나 왕복합니다. 최신 GPU에서 산술 연산 유닛의 속도는 메모리 버스의 전송 속도보다 수십 배에서 수백 배 빠릅니다. 따라서 실제 GPU의 연산 유닛은 극히 짧은 순간만 일하고, 대부분의 시간 동안 메모리 버스에서 다음 데이터가 도착하기만을 기다리는 메모리 대역폭 제한 상태에 갇히게 됩니다.
더 나아가 CPU 측면에서도 심각한 오버헤드가 누적됩니다. 파이썬 가상 머신은 바이트코드를 순회하며 전역 인터프리터 락(GIL)을 경합하고, 파이토치 C++ 런타임의 텐서 디스패처는 텐서의 데이터 타입과 장치 유형을 검사하여 알맞은 CUDA 구현체 함수 포인터를 찾기 위해 수많은 분기문을 탐색합니다. 연산 시간이 수 마이크로초에 불과한 소규모 커널들이 수백 번 연속 호출되면, GPU가 실제로 연산을 수행하는 시간보다 CPU가 커널 런치를 준비하는 디스패치 오버헤드가 더 커지는 역전 현상이 발생합니다.
파이토치 진영은 과거 TorchScript의 추적 기능(Trace)과 스크립트 변환(Script) 기능을 통해 이러한 한계를 돌파하려 했습니다. 그러나 추적 기능은 파이썬의 동적 조건 분기를 만났을 때 트레이싱 시점에 통과한 단 하나의 실행 경로만을 고정해 버려 묵묵부답의 수치 오류를 양산했습니다.
반면 스크립트 기능은 완전한 파이썬 인터프리터 수준의 추상 구문 트리를 재구현하려 했기 때문에, 조금만 복잡한 파이썬 객체 지향 문법이나 서드파티 라이브러리 함수가 등장하면 즉시 컴파일 파싱 실패 에러를 토해냈습니다. 엔지니어들은 컴파일을 위해 기존 코드를 거대하게 리팩토링해야 했고, 컴파일된 그래프 내부에서 오류가 발생하면 파이썬 표준 디버거를 사용할 수 없어 극심한 생산성 저하를 겪어야 했습니다.
TorchDynamo 프론트엔드: PEP 523 프레임 가로채기와 가드 시스템
TorchDynamo는 과거 정적 컴파일러들의 실패를 거울삼아 파이썬의 언어 철학을 정면으로 수용하는 혁신적인 프론트엔드 아키텍처로 탄생했습니다. 정적으로 코드를 파싱하는 대신, CPython 런타임 표준 메커니즘을 후킹하여 바이트코드가 실행되기 바로 직전 단계에서 프레임을 동적으로 낚아채는 전략을 채택한 것입니다.
PEP 523 프레임 평가 후크 메커니즘
CPython 3.6부터 도입된 PEP 523 표준은 CPython 인터프리터가 함수 실행 프레임을 평가할 때 호출하는 내부 함수 포인터를 외부 C 확장 모듈이 런타임에 덮어쓸 수 있도록 허용하는 공식 API를 제공합니다. TorchDynamo는 CPython 내부의 프레임 평가 함수 포인터를 자신만의 커스텀 C 함수로 가로챕니다.
사용자가 작성한 함수가 호출되는 순간, TorchDynamo의 평가 함수가 가장 먼저 활성화됩니다. 이 함수는 프레임에 적재된 순수 파이썬 바이트코드 스트림을 정밀하게 검사합니다.
TorchDynamo는 바이트코드를 순회하며 심볼릭 실행을 수행합니다. 파이토치 텐서 연산과 관련된 바이트코드 명령어가 나타나면, 이를 실제 텐서로 즉시 연산하는 대신 심볼릭 텐서 객체로 추상화하여 연산 노드를 가상 그래프에 차곡차곡 기록합니다.
만약 바이트코드 스트림 중간에 파이토치가 분석할 수 없는 임의의 파이썬 코드, 예를 들어 데이터베이스 조회 쿼리나 파일 시스템 입출력, 외부 C 라이브러리 호출과 같은 연산이 등장하면 어떻게 될까요? 과거 TorchScript라면 컴파일 실패 에러를 발생시켰을 것입니다.
그러나 TorchDynamo는 이 지점에서 우아하게 그래프를 쪼개는 그래프 브레이크 메커니즘을 작동시킵니다. 분석 불가능한 지점 직전까지 누적된 텐서 연산들만을 모아 하나의 독립된 컴파일 그래프로 묶어 백엔드로 전달하고, 지원되지 않는 순수 파이썬 명령어는 다시 표준 CPython 가상 머신에 제어권을 넘겨 안전하게 실행합니다. 그 후 다시 텐서 연산이 시작되는 지점에서 새로운 두 번째 컴파일 그래프를 생성합니다.
이 방식을 통해 사용자는 기존 파이썬 코드를 단 한 줄도 수정하지 않고도, 복잡한 제어 흐름과 외부 라이브러리가 뒤섞인 거대한 레거시 파이프라인에서 순수 딥러닝 연산 블록들만을 마법처럼 자동 추출하여 컴파일 혜택을 온전히 누릴 수 있게 됩니다.
가드 시스템과 초고속 캐시 적중
컴파일된 그래프를 반복 호출할 때마다 매번 바이트코드를 다시 가로채어 컴파일한다면 엄청난 오버헤드가 발생할 것입니다. TorchDynamo는 가드 시스템이라는 초경량 유효성 검증 프레임워크를 통해 이 문제를 완벽하게 해결합니다.
TorchDynamo가 파이썬 바이트코드를 분석하여 컴파일된 바이너리 아티팩트를 생성할 때, 해당 아티팩트와 1대1로 결합하는 가드 검증 표현식 세트를 함께 생성합니다. 가드는 해당 그래프가 유효하게 재사용될 수 있는 전제 조건들을 기술하는 일련의 초고속 C 수준 불리언 조건문입니다.
가드가 검증하는 항목들은 명확하고 엄격합니다.
- 입력 텐서의 랭크와 형태가 컴파일 당시의 차원과 일치하는지 여부
- 텐서 메모리의 스트라이드 레이아웃(연속 메모리 여부)이 동일한지 여부
- 텐서의 데이터 타입(FP32, FP16, BF16 등)이 변경되지 않았는지 여부
- 텐서가 위치한 디바이스 ID(CUDA:0 등)가 일치하는지 여부
- 파이썬 전역 변수나 객체 속성 중 연산 그래프 형성에 관여한 메타데이터가 변형되지 않았는지 여부
모델이 두 번째 호출될 때, TorchDynamo는 바이트코드를 다시 파싱하지 않고 오직 컴파일된 캐시 엔트리에 붙어 있는 가드 목록만을 순차 평가합니다. 이 검증 과정은 파이썬 객체 헤더의 포인터 비교와 정수 비교만으로 수행되므로 단 몇 나노초 만에 완료됩니다.
가드 조건이 모두 참으로 판정되면, CPython 인터프리터를 완전히 우회하고 기컴파일된 네이티브 GPU 머신 커널을 즉각 실행합니다. 반대로 입력 텐서의 배치가 바뀌거나 조건문 플래그가 변경되어 가드가 실패하면, 해당 프레임에 대해서만 새로운 특화 그래프를 추가 컴파일하여 캐시에 등록하는 다형적 캐싱을 수행합니다.
AOTAutograd와 FX Graph 중간 표현(IR) 정규화
TorchDynamo가 프레임을 성공적으로 가로채어 캡처한 그래프는 곧바로 하드웨어 백엔드로 내려가지 않습니다. 딥러닝 컴파일러가 해결해야 하는 또 다른 거대한 산은 바로 훈련 단계에서의 역전파 그래프 추출이기 때문입니다.
전통적인 파이토치 엔진에서 역전파는 런타임에 동적으로 Autograd 엔진이 노드를 추적하며 C++ 힙 공간에 연결 리스트를 빌드하는 방식으로 작동했습니다. 이는 컴파일러가 사전에 순전파와 역전파 연산자들을 한꺼번에 융합 최적화하는 것을 근본적으로 가로막는 장벽이었습니다.
Ahead-Of-Time 역전파 추출: AOTAutograd
AOTAutograd는 파이토치 컴파일러가 순전파 그래프뿐만 아니라 역전파 그래프까지 컴파일 타임에 사전에 완전히 포착할 수 있도록 만들어 주는 핵심 중간 계층입니다.
AOTAutograd는 컴파일 시점에 파이토치 디스패처의 메타 텐서 추적 도구인 make_fx를 가동합니다. 순전파 그래프를 심볼릭하게 실행한 뒤, 캡처된 연산 노드들에 대해 파이토치 내부 Autograd 메커니즘을 컴파일 타임에 미리 트리거하여 연쇄 법칙에 따른 역전파 그래프를 명시적인 정적 노드 집합으로 완전히 펼쳐냅니다.
이를 통해 컴파일러는 순전파 그래프와 역전파 그래프를 완벽히 통제할 수 있는 두 개의 독립된 중간 표현으로 확보하게 됩니다. 이는 활성화 체크포인팅이나 역전파 시점의 그래디언트 누적 연산, 가중치 업데이트 연산까지 하나의 통합된 관점에서 분석하고 메모리 라이프사이클을 극단적으로 최적화할 수 있는 강력한 토대를 제공합니다.
FX Graph 정규화 및 Core ATen IR 수렴
파이토치가 사용자에게 제공하는 고수준 API는 수천 개에 달합니다. 텐서를 쪼개고 결합하고 변형하는 메서드부터 다양한 변형 활성화 함수에 이르기까지 문법적 설탕이 방대하게 존재합니다. 컴파일러 백엔드가 수천 개에 달하는 고수준 API 각각에 대해 하드웨어 코드 생성기를 일일이 작성하는 것은 유지보수 관점에서 불가능에 가깝습니다.
AOTAutograd와 결합된 FX Graph 변환 계층은 이러한 수천 개의 파이토치 API 연산자들을 오직 수십 개의 원자적 기본 연산자로 구성된 Core ATen IR로 철저하게 정규화(Decomposition)합니다.
예를 들어 고수준의 LayerNorm 연산은 통계량 추출을 위한 평균 연산, 분산 연산, 감산, 제곱근, 나눗셈, 그리고 가중치 곱셈과 편향 덧셈이라는 가장 기초적인 점별 연산 노드들로 완전히 분해됩니다.
이렇게 정규화된 FX Graph는 다음과 같은 강력한 그래프 최적화 패스들을 통과합니다.
- 죽은 코드 제거: 후속 연산에서 참조되지 않는 불필요한 중간 텐서 생성 노드를 추적하여 완전히 삭제합니다.
- 공통 부분식 제거: 동일한 입력에 대해 중복으로 수행되는 연산 노드를 하나로 합쳐 단 한 번만 계산되도록 그래프를 단순화합니다.
- 심볼릭 정수(SymInt) 바인딩: 텐서의 크기가 동적으로 변하는 경우에도 구체적인 숫자 대신 기호 변수를 사용하여 단일 컴파일 그래프가 다양한 가변 길이 시퀀스를 처리할 수 있도록 셰이프 표현을 추상화합니다.
TorchInductor 백엔드: 패턴 매칭과 루프 융합
AOTAutograd와 FX Graph 계층을 거쳐 완벽하게 정제된 Core ATen 그래프는 최종 컴파일러 백엔드인 TorchInductor에 도달합니다. TorchInductor는 정규화된 그래프 노드들을 실제 하드웨어 가속기에서 실행 가능한 극강의 고성능 머신 코드로 번역하는 중추적인 컴파일러 백엔드 엔진입니다.
TorchInductor의 가장 위대한 기술적 공헌은 바로 메모리 바운드 연산자들을 하나의 거대한 연산 블록으로 합쳐 버리는 고도화된 루프 융합 알고리즘입니다.
수직 융합과 수평 융합의 시너지
딥러닝 모델의 실행 시간 중 상당 부분은 점별 연산(Pointwise)과 리덕션 연산(Reduction)에서 소모됩니다. TorchInductor는 이 두 가지 영역에서 하드웨어 메모리 트래픽을 원천적으로 증발시키는 두 가지 차원의 융합을 수행합니다.
첫 번째는 수직 융합(Vertical Fusion)입니다. 이전 연산자의 출력이 다음 연산자의 입력으로 직결되는 연속적인 연산 파이프라인에서, 중간 결과물을 GPU 고대역폭 메모리에 기록하지 않고 온칩 레지스터에 머무르게 한 채 다음 연산을 연쇄 수행합니다.
행렬 곱셈 이후에 이어지는 바이어스 덧셈, 드롭아웃 마스킹, GELU 활성화 함수, 잔차 연결 덧셈이 모두 하나의 단일 커널로 수직 결합됩니다. 이를 통해 텐서 데이터가 글로벌 메모리 버스를 타고 나갈 필요 없이 온칩 레지스터 내부에서 모든 계산이 완결됩니다.
두 번째는 수평 융합(Horizontal Fusion)입니다. 서로 다른 두 개 이상의 연산자가 동일한 입력 텐서를 읽거나 유사한 메모리 순회 패턴을 공유할 때, 이 연산자들의 루프를 하나로 합쳐 메모리 로드 연산을 단 한 번으로 통합합니다.
입력 텐서의 평균을 구하는 리덕션 루프와 동일 텐서의 분산을 구하는 리덕션 루프를 개별적으로 두 번 순회하지 않고, 단일 패스 루프 내부에서 평균 누적값과 제곱합 누적값을 동시에 연산하는 식입니다. 메모리 로드 횟수가 절반으로 줄어들며 캐시 오염을 극적으로 방지합니다.
정적 메모리 플래닝 및 피크 VRAM 절감
TorchInductor는 그래프 전체의 텐서 수명 주기를 정적으로 시뮬레이션할 수 있습니다. 어떤 중간 텐서가 생성되어 어느 연산자에서 마지막으로 소비되는지 정확한 타임라인을 파악하고 있으므로, 수명이 다한 텐서의 메모리 버퍼를 새롭게 생성되는 다른 텐서의 저장 공간으로 즉시 재할당하는 정적 버퍼 재사용을 완벽하게 구현합니다.
동적 메모리 할당자인 CUDACachingAllocator에 메모리 할당 및 해제 요청을 빈번하게 던지지 않고, 컴파일 시점에 미리 계산된 단일 거대 워크스페이스 메모리 풀 내부에서 오프셋만을 이동하며 버퍼를 재활용합니다. 이는 메모리 파편화를 제로화하고, 대규모 모델 훈련 시 피크 VRAM 사용량을 30퍼센트 이상 극적으로 절감시키는 혁신적인 효과를 낳습니다.
Triton 코드 생성 엔진: 하드웨어 네이티브 가속
TorchInductor가 기존 컴파일러들과 차별화되는 가장 독보적인 설계 결정은 코드 생성 대상 언어로 복잡한 C++ CUDA가 아니라 OpenAI가 개발한 오픈소스 GPU 프로그래밍 언어인 Triton을 선택했다는 점입니다.
과거의 AI 컴파일러 백엔드들은 C++ CUDA 코드를 생성하거나 독자적인 저수준 어셈블리를 직접 합성하려 시도했습니다. 그러나 현대 GPU 하드웨어는 수많은 워프 스케줄러, 공유 메모리 뱅크 충돌 방지, 비동기 데이터 복사, 텐서 코어 레지스터 타일링 등 인간 엔지니어조차 최적화하기 극도로 까다로운 복잡성을 지니고 있습니다.
Triton은 이러한 하드웨어의 미시적인 저수준 제어를 컴파일러 레벨로 추상화하고, 개발자에게는 2차원 블록 단위의 프로그래밍 모델만을 요구합니다. TorchInductor는 FX Graph의 노드 순회 논리를 Triton 언어의 타일 블록 루프로 직결 변환하는 코드 합성 템플릿을 탑재했습니다.
TorchInductor가 생성하는 Triton 커널은 다음과 같은 하드웨어 가속 기법들을 자동으로 장착합니다.
- 블록 크기 및 워프 개수 자동 튜닝: 타깃 GPU가 Ampere 아키텍처인지 Hopper 아키텍처인지 감지하고, 컴파일 타임에 다양한 블록 크기 조합을 실제로 실행해 보며 최적의 공유 메모리 점유율을 달성하는 파라미터를 자동 선별합니다.
- 포인터 산술 연산 최소화: 다차원 텐서의 인덱스 계산을 선형 스트라이드 연산으로 평탄화하고, SIMD 벡터화 로드 명령어를 통해 고대역폭 메모리에서 128비트 단위의 정렬된 트랜잭션으로 데이터를 한 번에 빨아들입니다.
- C++ 런타임 래퍼 합성: 파이썬 인터프리터의 오버헤드를 완전히 소거하기 위해, 생성된 Triton 커널을 호출하는 초경량 C++ 드라이버 코드를 함께 컴파일하여 CPython 디스패치 경로 자체를 원천 우회합니다.
순수 파이썬 기반 TorchDynamo & Guard 프레임워크 에뮬레이터 코드
TorchDynamo의 바이트코드 심볼릭 분석 및 가드 검증 파이프라인, 그리고 중간 텐서 융합 메커니즘을 명확하게 파악할 수 있도록 순수 파이썬과 파이토치 메서드만으로 구축한 컴파일러 스택 시뮬레이터입니다.
곱셈 기호나 인라인 번호 매김 없이, 안전한 텐서 연산과 함수형 래퍼만을 활용하여 프레임 가로채기와 가드 캐시 적중 과정을 투명하게 시뮬레이션합니다.
# PyTorch 2.0 Compiler Stack Emulator: Dynamo Frame Capture, Guards & Fusion
# Simulates bytecode inspection, guard caching, and Inductor Triton kernel fusion

import torch
import math
import time

class TensorGuard:
    # Validates whether an incoming tensor strictly matches the compiled graph assumptions
    def __init__(self, shape, stride, dtype, device):
        self.shape = shape
        self.stride = stride
        self.dtype = dtype
        self.device = device

    def check(self, tensor):
        if tensor.shape != self.shape:
            return False
        if tensor.stride() != self.stride:
            return False
        if tensor.dtype != self.dtype:
            return False
        if tensor.device != self.device:
            return False
        return True

class CompiledArtifact:
    def __init__(self, guard, fused_kernel_fn):
        self.guard = guard
        self.fused_kernel_fn = fused_kernel_fn
        self.execution_count = 0

class TorchDynamoEmulator:
    def __init__(self):
        # Cache holding compiled artifacts mapped by operation signatures
        self.compilation_cache = []
        self.compilation_events = 0
        self.cache_hits = 0

    def compile_fused_transformer_block(self, sample_x, sample_w, sample_bias):
        # Simulates AOTAutograd and TorchInductor generating a fused Triton kernel
        # In eager mode, these are 4 separate kernels: matmul, bias_add, gelu, residual_add
        def fused_triton_kernel(x, w, bias, residual):
            # Step 1: GEMM
            proj = torch.matmul(x, w)
            # Step 2: Fused Bias + GELU + Residual (Simulated single-pass on-chip register op)
            # Avoiding multiple HBM round trips
            biased = proj.add(bias)
            # Fast GELU approximation via tanh series expansion
            # Mathematical formulation: 0.5 mul x mul (1.0 add tanh(sqrt(2/pi) mul (x add 0.044715 mul x^3)))
            # Implemented with safe method calls
            inner = biased.add(torch.pow(biased, 3).mul(0.044715))
            c = math.sqrt(2.0 / math.pi)
            tanh_out = torch.tanh(inner.mul(c))
            gelu_out = biased.mul(tanh_out.add(1.0)).mul(0.5)
            # Final in-place residual addition
            return gelu_out.add(residual)

        # Create guards for all inputs
        guards = [
            TensorGuard(sample_x.shape, sample_x.stride(), sample_x.dtype, sample_x.device),
            TensorGuard(sample_w.shape, sample_w.stride(), sample_w.dtype, sample_w.device),
            TensorGuard(sample_bias.shape, sample_bias.stride(), sample_bias.dtype, sample_bias.device),
        ]

        artifact = CompiledArtifact(guards, fused_triton_kernel)
        self.compilation_cache.append(artifact)
        self.compilation_events += 1
        return artifact

    def execute(self, x, w, bias, residual):
        # 1. Fast Guard Verification across cache
        for artifact in self.compilation_cache:
            g0, g1, g2 = artifact.guard
            if g0.check(x) and g1.check(w) and g2.check(bias):
                self.cache_hits += 1
                artifact.execution_count += 1
                # Fast path: invoke compiled fused kernel directly, zero bytecode overhead
                return artifact.fused_kernel_fn(x, w, bias, residual)

        # 2. Guard Miss: Fallback to dynamic graph compilation (First run or shape change)
        print("Guard Miss detected: Triggering Dynamo frame capture & Inductor codegen...")
        new_artifact = self.compile_fused_transformer_block(x, w, bias)
        new_artifact.execution_count += 1
        return new_artifact.fused_kernel_fn(x, w, bias, residual)

def run_compiler_demonstration():
    torch.manual_seed(42)
    device = "cpu"

    batch_size = 4
    seq_len = 128
    hidden_dim = 256

    # Inputs
    x = torch.randn(batch_size, seq_len, hidden_dim, device=device)
    w = torch.randn(hidden_dim, hidden_dim, device=device)
    bias = torch.randn(hidden_dim, device=device)
    residual = torch.randn(batch_size, seq_len, hidden_dim, device=device)

    # 1. Eager Mode Reference Execution
    def eager_forward(x_in, w_in, b_in, res_in):
        step1 = torch.matmul(x_in, w_in)
        step2 = step1.add(b_in)
        step3 = torch.nn.functional.gelu(step2)
        step4 = step3.add(res_in)
        return step4

    ref_out = eager_forward(x, w, bias, residual)

    # 2. Dynamo & Inductor Compiler Emulator
    compiler = TorchDynamoEmulator()

    # First call: triggers compilation
    comp_out1 = compiler.execute(x, w, bias, residual)
    diff = torch.max(torch.abs(ref_out - comp_out1)).item()
    print(f"Compilation Run 1: Numerical Deviation = {diff:.2e}")
    assert diff < 1e-4, "Compiled kernel numerical divergence!"

    # Second call: must hit guard cache instantly
    comp_out2 = compiler.execute(x, w, bias, residual)
    print(f"Compilation Run 2: Cache hits = {compiler.cache_hits}, Total compilations = {compiler.compilation_events}")
    assert compiler.cache_hits == 1, "Guard cache should have been hit!"

    # Third call with mutated tensor shape (Triggering re-compilation / Polymorphic dispatch)
    x_mutated = torch.randn(8, seq_len, hidden_dim, device=device)
    residual_mutated = torch.randn(8, seq_len, hidden_dim, device=device)
    comp_out3 = compiler.execute(x_mutated, w, bias, residual_mutated)
    print(f"Compilation Run 3 (Dynamic Shape): Total compilations = {compiler.compilation_events}")
    assert compiler.compilation_events == 2, "Dynamic shape should trigger secondary specialized compilation!"

if __name__ == "__main__":
    run_compiler_demonstration()
위 코드는 런타임에 일어나는 CPython 프레임 인터셉션과 가드 조건 평가, 그리고 4개의 분절된 파이토치 오퍼레이터가 단일 융합 연산자로 합쳐지는 메커니즘을 명료하게 보여줍니다.
동일한 형상의 텐서가 유입될 때 가드 체인을 단 수십 사이클 내에 통과하여 캐시 히트를 달성하고, 텐서 형상이 변동될 때 새로운 아티팩트를 컴파일하여 다형적 디스패치를 수행하는 파이토치 2.0 컴파일러의 견고한 생명주기가 입증됩니다.
실전 벤치마크 및 프로덕션 환경에서의 컴파일 튜닝 전략
실제 현업 프로덕션 시스템에서 torch.compile을 적용할 때, 엔지니어는 모델의 아키텍처와 서빙 시나리오에 따라 적절한 컴파일러 백엔드 옵션과 가드 전략을 선택해야 합니다.
컴파일 모드별 성능 및 리소스 트레이드오프
torch.compile 함수는 모델의 목적에 따라 세 가지 대표적인 최적화 프리셋을 제공합니다.
- 기본 모드(
mode="default"): 컴파일 시간을 최소화하면서 가장 일반적인 수직 루프 융합과 Dead Code Elimination을 수행합니다. 개발 및 반복적인 실험 단계에서 가장 적합하며, 일반적으로 15퍼센트에서 30퍼센트의 속도 향상을 즉시 제공합니다. - 오버헤드 감축 모드(
mode="reduce-overhead"): CUDA Graphs 기술을 내부적으로 통합하여 CPU-GPU 간의 커널 런치 오버헤드를 제로 수준으로 수렴시킵니다. 배치 크기가 작고 모델이 가벼워 CPU 디스패치 병목이 심한 실시간 추론 서비스에서 극적인 위력을 발휘합니다. 단, 메모리 주소가 고정되어야 하므로 VRAM 사용량이 다소 증가할 수 있습니다. - 최대 오토튜닝 모드(
mode="max-autotune"): TorchInductor가 코드 생성 시 탐색할 수 있는 모든 Triton 타일 크기와 행렬 곱셈 알고리즘(Triton, cuBLAS, CUTLASS)을 실제 GPU에서 직접 실행하며 벤치마킹합니다. 초기 컴파일 시간은 수 분에서 수십 분까지 길어지지만, 대규모 LLM 훈련이나 장기 가동되는 엔터프라이즈 배치 서빙 환경에서 최고의 하드웨어 처리량을 보장합니다.
그래프 브레이크 진단 및 프로덕션 최적화 지침
컴파일 효과를 극대화하기 위해 엔지니어가 반드시 수행해야 하는 필수 점검 작업은 그래프 브레이크의 위치를 찾아내어 제거하는 것입니다.
코드 중간에 print() 함수나 tensor.item(), 파이썬 표준 리스트 조작문이 포함되어 있으면 TorchDynamo는 불가피하게 그래프를 조각내어 CPython 인터프리터로 폴백합니다. 그래프가 쪼개지면 융합할 수 있는 연산자의 범위가 좁아지고, 그래프 간 전환 오버헤드가 추가되어 컴파일 효과가 반감됩니다.
엔지니어는 파이토치 내장 진단 도구인 torch._dynamo.explain 함수를 호출하거나, 환경 변수 TORCH_LOGS="graph_breaks"를 설정하여 모델 실행 중 어느 라인에서 그래프 브레이크가 발생하는지 명확한 스택 트레이스를 추적할 수 있습니다.
추론 환경에서 시퀀스 길이가 매 요청마다 변하는 동적 입력(Dynamic Shapes)을 다룰 때는 dynamic=True 플래그를 명시해야 합니다. 이를 생략하면 매 시퀀스 길이마다 새로운 그래프를 컴파일하는 컴파일 스톰 현상이 발생하여 서버 레이턴시가 폭증할 수 있습니다.
파이토치 2.0+ 컴파일러 스택은 연구 개발의 유연성과 프로덕션 하드웨어의 초고속 성능이라는 양립하기 어려웠던 두 마리 토끼를 완벽하게 잡아낸 현대 AI 인프라 소프트웨어의 정점입니다. 이를 올바르게 이해하고 시스템에 적용하는 엔지니어링 역량은 차세대 거대 언어 모델과 AI 에이전트 인프라의 가성비와 처리량을 결정짓는 핵심 경쟁력이 될 것입니다.